Фильтры каталога тильда seo
Представьте интернет магазин на Tilda с полноценным каталогом товаров, где покупатели могут фильтровать товары по разным параметрам, выбирая нужные варианты с мобильной версии или десктопа. Клиентам нужно быстро найти товар по размеру, цвету и цене. Но вот что видят поисковые системы и Google с Яндексом: каждая комбинация фильтров каталога тильда seo на сайте на tilda становится отдельной страницей в индексации. Одна рубашка выглядит 50 различными товарами в каталоге вашего интернет магазина. Это серьёзное дублирование контента. Поисковые системы теряют доверие к таким сайтам, и органический трафик падает на 20–50%. Многие владельцы сайтов интернет-магазинов на тильде не видят проблему до проведения технического аудита сайта. Но правильная настройка фильтров в Tilda — один из мощнейших способов seo-продвижения сайта. Верная структура сайта может вернуть потерянный трафик и добавить 30–50% органического роста. Без переделки всей работы сайта. Просто нужно понять основные правила seo-оптимизации сайта для этой платформы и провести базовые настройки.
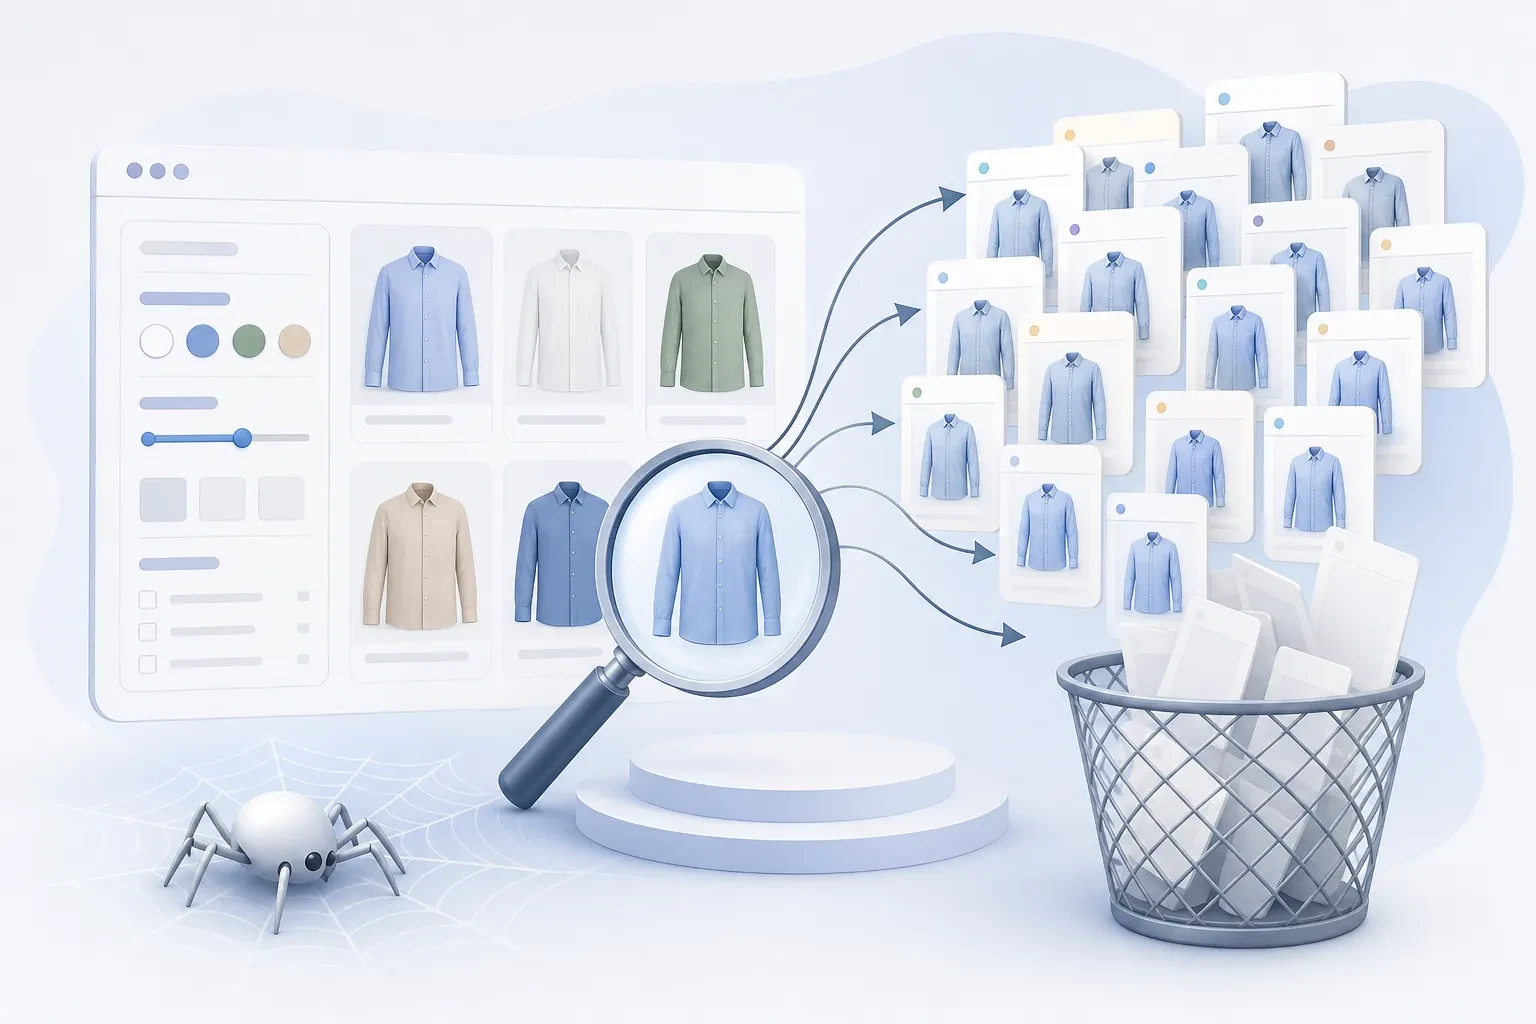
Почему фильтры создают дублирование контента: угрозы для видимости сайта на Tilda в Google
Как работают параметры URL в фильтрах каталога Tilda
На Tilda параметры URL в фильтрах каталога товаров — это не просто удобство для посетителей. Это код, который создает отдельные адреса для каждой комбинации фильтров. Когда клиент вашего интернет-магазина выбирает размер L и красный цвет, браузер показывает ему URL типа site.ru/catalog?filter=size=L&color=red. Когда он переходит на другой размер — site.ru/catalog?filter=size=M&color=red. Это две разные ссылки на один и тот же товар из каталога товаров.
По умолчанию в Tilda фильтры создают именно такие параметрические URL с параметрами. То есть платформа Tilda автоматически генерирует новый адрес для каждого сочетания фильтров. Это работает просто с точки зрения пользователя — он кликает, фильтр применяется, страница обновляется без полной перезагрузки. Но с точки зрения seo на tilda это становится серьёзной проблемой для продвижения сайта и его видимости в результатах поиска, которые видят поисковые роботы.
Вспомните нашу рубашку из каталога товаров. В магазине она существует в размерах S, M, L, XL и цветах: чёрный, синий, красный, белый. Это 4 размера × 4 цвета = 16 дублирующихся версий одного товара. Плюс фильтры по цене, материалу, различные варианты сортировки по популярности или цене — дублей становятся сотни и даже тысячи. Один товар в каталоге товаров глазами поисковых систем выглядит как десятки разных товаров, размещаясь на разных страницах.
Как поисковые системы видят дублирование контента
Google и Яндекс обходят сайты на тильде как обычные пользователи, используя специальных поисковых роботов, которые проверяют каждую страницу и её параметры. Когда робот встречает URL с параметрами фильтров, он видит это как новую страницу. Её заголовок h1, описание товара, цена, изображения — всё то же. Но ссылка другая, значит, это отдельная страница для индексации в поисковой выдаче.
Вот что происходит в реальности при работе поисковых роботов. Поисковый робот заходит на сайт на тильде и находит основной URL товара — /rub-zhenskaya-krasnyy/. Потом он находит ссылку с фильтром размера — /rub-zhenskaya-krasnyy?filter=size=L. Потом ещё одну — с цветом и ценой — /rub-zhenskaya-krasnyy?filter=size=L&color=blue&price=100-500. Робот не понимает, что это один товар с разными вариантами. Он индексирует каждый как отдельную страницу в результатах поиска.
Google обычно недолюбливает дублирование контента, когда видит множество подобных ссылок с одинаковым контентом — он начинает сомневаться, на какую версию ссылаться в результатах поиска. Это размывает релевантность товара. Сайт на тильде выглядит как спам или технически неграмотный интернет магазин. Поисковые системы не доверяют таким магазинам и понижают их позиции в выдаче.
Кроме того, робот тратит свой краулинг-бюджет на эти дублирующиеся страницы. Краулинг-бюджет — это примерно время, которое поисковые системы выделяют на обход вашего сайта. Если страницы каталога товаров на тильде состоят из сотен дублей, робот потратит время на них вместо того, чтобы обойти действительно новые и уникальные материалы — новые страницы в блоге, страницы услуг, отдельные категории товаров.
Реальный пример: один товар создает множество версий
Возьмем конкретный сайт-каталог интернет-магазина на тильде. У него в каталоге товаров есть 500 товаров для эффективного продвижения сайта на тильде. Каждый товар в каталоге существует в трёх размерах и пяти цветах. Плюс три варианта сортировки (по популярности, цене, новизне). Плюс две опции постраничного отображения (12 товаров на странице, 24 товара на странице).
Математика простая: 500 товаров × 3 размера × 5 цветов × 3 сортировки × 2 пагинации = 45 миллионов URL по бумаге. На деле в индексации окажется несколько тысяч, но все равно это гораздо больше реально существующих товаров в каталоге товаров на тильде.
Google отправляет робота на сайт на tilda. Робот начинает обходить эти дублирующиеся страницы. Первый месяц сайта на тильде выглядит нормально — контент есть, внутренние ссылки работают. Но через два-три месяца Google разбирается, что тут происходит. Он видит чёткие принципы дублирования контента в структуре URL и начинает их игнорировать при учёте факторов ранжирования.
Как это влияет на трафик и видимость
Падение органического трафика происходит именно в этот момент. Владелец интернет-магазина через месяц-два замечает понижение видимости: трафик рос, а потом упал на 20-50%. Позиции в результатах поиска Google снизились. На ключевые запросы и поисковые запросы, по которым товар ранжировался хорошо, он исчез из первой страницы выдачи.
Почему это происходит? Причина — дублирование контента на сайте каталога. Google не может выбрать, какую версию товара показывать в результатах поиска. Если ввести запрос пользователя типа «чёрная рубашка размер M», может появиться как основная страница товара, так и версия с параметром фильтра. Или не появиться вообще в выдаче поисковой системы.
Размытие релевантности — вот настоящее имя этой проблемы в seo на тильде. Поисковые системы перестают понимать, что действительно ценно в вашем магазине. Google видит сотни похожих страниц в каталоге товаров и думает, что вы пытаетесь что-то скрыть или манипулировать результатами поиска. Результат — понижение видимости в поиске. Не явный штраф, но вполне реальное снижение позиций.
При этом потеря бюджета краулинга из-за дублирования контента — это тоже серьёзная проблема для многостраничного сайта. Если Google отправляет робота раз в неделю и у вас есть 5000 дублей вместо 500 реальных товаров, робот просто не обойдёт 90% вашего сайта за неделю. Новые страницы будут добавляться в индекс медленнее. Изменения на сайте на tilda будут отражаться в поиске чуть ли не месяц.
Как проверить дублирование контента в Google Search Console
Откройте Google Search Console для вашего сайта на тильде — этот встроенный инструмент доступен в личном кабинете вашего сайта tilda. Перейдите в раздел «Покрытие» (Coverage). Здесь Google показывает, сколько страниц индексировано, сколько ошибок, сколько исключено из индексации.
Прокрутите вниз до «Исключено» (Excluded). Посмотрите, есть ли там огромное число страниц с пометкой «Исключено: дублирующийся контент» (Duplicate, Google-selected canonical) или «Исключено: параметр не нужен» (Excluded by 'noindex' tag). Если чисел много — это явный признак проблемы с фильтрами.
Второй шаг — перейдите в «Производительность» (Performance). Посмотрите табуляцию по URL. Нажмите на любой товар из каталога товаров и посмотрите его статистику. Вы увидите несколько вариантов ссылки одного товара с разными параметрами фильтров. Это подтверждает дублирование контента на разных страницах вашего сайта.
Третий способ — используйте встроенный инструмент «URL Inspection» (Проверка URL). Введите ссылку товара с параметром фильтра. Google покажет, какую версию он выбрал как основную (canonical), какую исключил из результатов. Если основная версия имеет параметры фильтра, это серьёзная проблема для seo-продвижения сайта на тильде.
Метрики, которые надо отслеживать
В Google Search Console смотрите три основных метрики, которые помогают поисковикам и владельцам сайтов понять здоровье проекта интернет магазина:
Первая — количество индексированных страниц. Если в каталоге товаров 300 товаров, а индексировано 6000 страниц, это дублирование контента. Обычно реальное количество страниц должно совпадать или быть немного больше (из-за пагинации и действительно нужных фильтров).
Вторая — процент исключённых страниц из-за дублирования контента. Если больше 30%, необходимо срочно оптимизировать структуру каталога товаров.
Третья — средняя позиция и количество кликов по основным товарам. Если позиции снизились на 5-10 мест или клики упали на 20%, виновато дублирование контента. Сайт на тильде потерял видимость в результатах поиска.
Также проверьте Яндекс.Вебмастер — там аналогичные данные и информация о параметрах фильтров. Яндекс обычно мягче относится к дублям, но тоже штрафует за слишком явное дублирование контента и помогает поисковикам лучше понимать структуру сайта.
Ещё полезный инструмент — site: запрос в поиске Google или Яндекс. Наберите в поисковой системе site:yourdomain.ru товар (например, site:shop.ru «рубашка красная»). Посмотрите, сколько результатов выдаст поисковая машина. Если десятки похожих ссылок от одного товара — дублирование подтверждено. Если несколько уникальных ссылок — это норма.